Biometrische Grundlagen
Biometrische Werkzeuge, mit denen Studien zu Arzneimitteln geplant, ausgewertet und gelesen werden. Im Kern stehen p-Wert und Konfidenzintervall, Fehlerarten und Power sowie die Effektmaße RR, ARR, RRR und NNT mit dem Kontrast zwischen relativer und absoluter Darstellung.
Dein roter Faden
- Daten beschreiben: Das Skalenniveau bestimmt die Kennwerte; Mittelwert mit SD bei normalverteilten, Median mit Interquartilsabstand bei schiefen oder ordinalen Daten.
- SD vs. SE: Die SD beschreibt die Streuung der Einzelwerte, der SE = SD/√n die Präzision des Mittelwerts und sinkt mit wachsender Fallzahl.
- Testen und Schätzen: Der p-Wert ist die Wahrscheinlichkeit der Daten unter H₀; das Konfidenzintervall zeigt Effektgröße und Präzision und ist informativer.
- Fehlerarten und Power: Fehler 1. Art ist falsch positiv (α), Fehler 2. Art falsch negativ (β); die Power 1 − β bestimmt mit Effekt, Streuung und α die Fallzahl.
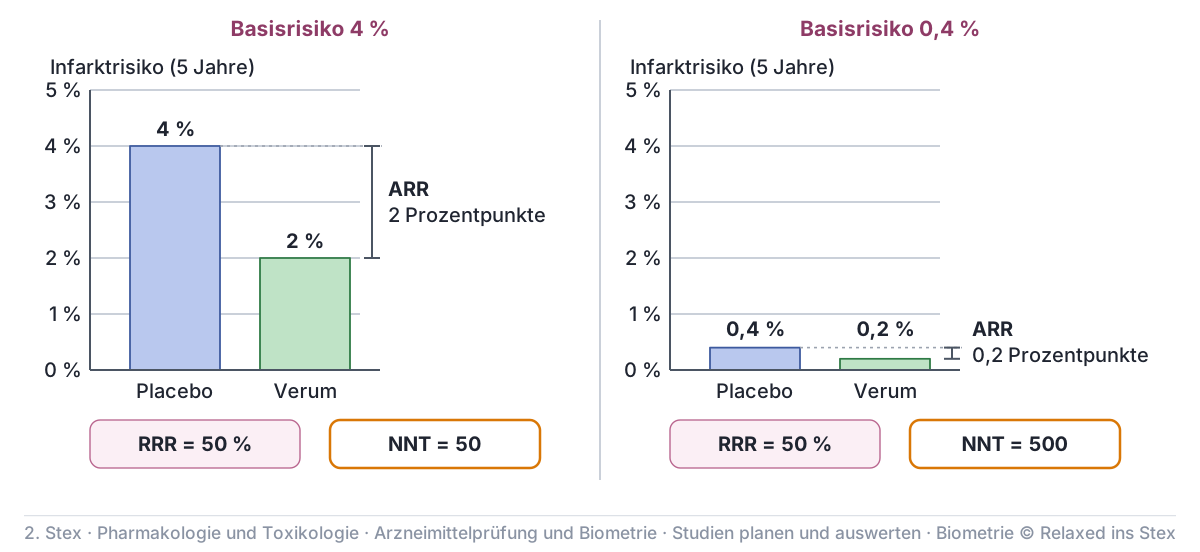
- Effektmaße rechnen: Bei 4 % vs. 2 % Risiko sind RR 0,5, RRR 50 %, ARR 2 Prozentpunkte und NNT 50.
- Relativ vs. absolut: Die RRR ist vom Basisrisiko unabhängig und klingt groß; den Nutzen für Patienten zeigen ARR und NNT.
- Diagnostische Güte: Sensitivität und Spezifität sind Testeigenschaften, PPV und NPV hängen von der Prävalenz ab; bei niedriger Prävalenz ist der PPV klein.
Kostenlos weiterlesen mit deinem Relaxed-Konto
Lege dir ein kostenloses Konto an, dann ist das ganze 2. Staatsexamen für dich frei. Kein Abo, keine Zahlungsdaten.
Bitte bestätige zuerst deine E-Mail-Adresse
Wir haben dir einen Link geschickt. Mit bestätigter E-Mail-Adresse liest du hier gleich weiter.
Daten und Skalen
Biometrie liefert die Methoden, mit denen Wirksamkeit und Sicherheit von Arzneimitteln belegt werden. Den Rahmen setzt das Studiendesign. Das Skalenniveau eines Merkmals bestimmt, welche Kennwerte und Tests zulässig sind:
- Nominal: Kategorien ohne Rangfolge (Blutgruppe, Ereignis ja/nein).
- Ordinal: Rangfolge ohne gleiche Abstände (Schmerzskala, NYHA-Stadium).
- Metrisch: gleiche Abstände, Differenzen sinnvoll (Blutdruck, HbA1c).
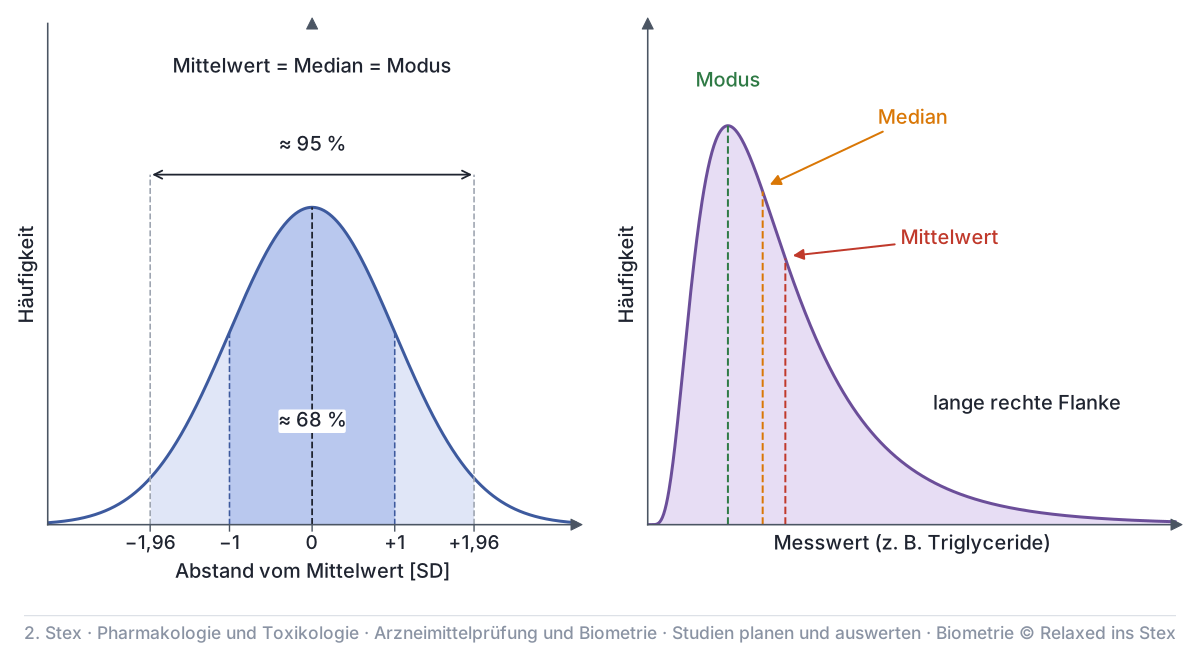
Die Normalverteilung ist symmetrisch und glockenförmig, Mittelwert, Median und Modus fallen zusammen. Etwa 68 % der Werte liegen innerhalb ±1 Standardabweichung, etwa 95 % innerhalb ±1,96. Viele biologische Größen sind dagegen rechtsschief (Triglyceride, Liegedauer).
Gemessen wird an einer Stichprobe, geschlossen wird auf die Grundgesamtheit. Deshalb braucht jedes Ergebnis ein Maß seiner Unsicherheit.
Beschreibende Statistik
Lage- und Streuungsmaße fassen eine Stichprobe zusammen. Welche passen, hängt von Skala und Verteilung ab:
- Mittelwert: Summe durch n, ausreißerempfindlich; bei normalverteilten metrischen Daten, zusammen mit der Standardabweichung.
- Median: teilt die geordneten Werte in zwei Hälften, robust; bei ordinalen und schiefen Daten, zusammen mit dem Interquartilsabstand (25. bis 75. Perzentile).
- Modus: häufigster Wert, einziges Lagemaß für nominale Daten.
- Varianz und Standardabweichung (SD): mittlere quadrierte Abweichung vom Mittelwert bzw. deren Wurzel, damit in der Einheit der Messwerte.
Streuung der Einzelwerte um den Mittelwert. Beschreibt die Stichprobe und bleibt bei wachsendem n etwa gleich.
SE = SD/√n: Präzision des geschätzten Mittelwerts. Sinkt mit wachsendem n und ist die Grundlage des Konfidenzintervalls.
Ein Korrelationskoeffizient (r von −1 bis +1) beschreibt einen Zusammenhang, keine Ursache: Ein Confounder kann beide Größen treiben. Kausalität belegt erst die randomisierte Studie.
Schätzen und Testen
Ein Test prüft die Nullhypothese H₀ (kein Unterschied) gegen die Alternativhypothese H₁. Der p-Wert ist die Wahrscheinlichkeit, unter Gültigkeit von H₀ ein mindestens so extremes Ergebnis zu beobachten. Liegt er unter dem vorab festgelegten Signifikanzniveau α (meist 0,05), wird H₀ verworfen.
| Testentscheidung | H₀ wahr | H₀ falsch |
|---|---|---|
| H₀ verworfen | Fehler 1. Art (α), falsch positiv | richtig: Power (1 − β) |
| H₀ beibehalten | richtig | Fehler 2. Art (β), falsch negativ |
- Konfidenzintervall (KI): Das 95-%-KI überdeckt bei wiederholten Studien in 95 % der Fälle den wahren Wert. Schließt es den Nullwert aus (Differenz 0, Ratio 1), ist das Ergebnis bei α = 0,05 signifikant; die Lage zeigt die Effektgröße, die Breite die Präzision.
- Statistische vs. klinische Relevanz: Bei großer Fallzahl wird auch ein winziger Unterschied signifikant; ob er für Patienten zählt, zeigt erst die Effektgröße.
- Multiples Testen: Jeder weitere Test erhöht die Chance auf ein Zufallsergebnis (bei 20 Tests mit α = 0,05 ist eines zu erwarten). Gegenmittel: vorab festgelegter primärer Endpunkt, Bonferroni-Korrektur (α durch Anzahl der Tests).
- Testwahl: parametrisch (t-Test) bei normalverteilten metrischen Daten, nichtparametrisch (Mann-Whitney-U, Wilcoxon) bei ordinalen oder schiefen Daten, Chi-Quadrat-Test für Häufigkeiten.
Antwort anzeigen
Nein. Der p-Wert ist die Wahrscheinlichkeit der beobachteten oder extremerer Daten unter der Annahme, dass H₀ gilt, nicht die Wahrscheinlichkeit von H₀ selbst. Über Größe und klinische Bedeutung des Effekts sagt er nichts. Deshalb berichtet man den Effektschätzer mit Konfidenzintervall.
Fallzahlplanung
Die Fallzahlplanung legt vor Studienbeginn fest, wie viele Patienten nötig sind, um einen klinisch relevanten Effekt mit ausreichender Power (meist 80 bis 90 %) zu erkennen. Die Fallzahl steigt bei:
- kleinerem Effekt: feinere Unterschiede brauchen mehr Information.
- größerer Streuung: das Signal geht im Rauschen unter.
- strengerem α und höherer Power: weniger Fehler 1. bzw. 2. Art kosten Patienten.
Zu kleine Studien sind unterpowert: Ein fehlender Nachweis ist kein Nachweis fehlender Wirkung, und zufällig signifikante Ergebnisse überschätzen den Effekt. Seltene UAW erfassen Zulassungsstudien kaum. Nach der Dreierregel braucht man rund 3 × n Patienten, um ein Ereignis der Häufigkeit 1 : n mit 95 % Wahrscheinlichkeit mindestens einmal zu sehen, deshalb die Pharmakovigilanz.
Effektmaße
Die Effektmaße lassen sich an einem Rechenbeispiel ableiten: Über fünf Jahre erleiden unter Placebo 40 von 1.000, unter Verum 20 von 1.000 Patienten einen Herzinfarkt.
| Gruppe | Infarkt | kein Infarkt | Risiko |
|---|---|---|---|
| Verum | 20 | 980 | 2 % |
| Placebo | 40 | 960 | 4 % |
- Relatives Risiko (RR): Risiko Verum durch Risiko Placebo = 2 % / 4 % = 0,5.
- Relative Risikoreduktion (RRR): 1 − RR = 50 %.
- Absolute Risikoreduktion (ARR): 4 % − 2 % = 2 Prozentpunkte.
- Number needed to treat (NNT): 1/ARR = 50: So viele Patienten müssen fünf Jahre behandelt werden, damit einer keinen Infarkt erleidet. Analog die Number needed to harm (NNH) = 1/absolute Risikozunahme einer UAW.
- Odds Ratio (OR): Quotient der Chancen (Ereignisse durch Nicht-Ereignisse), hier (20/980)/(40/960) ≈ 0,49; typisch für Fall-Kontroll-Studien, bei seltenen Ereignissen nahe am RR.
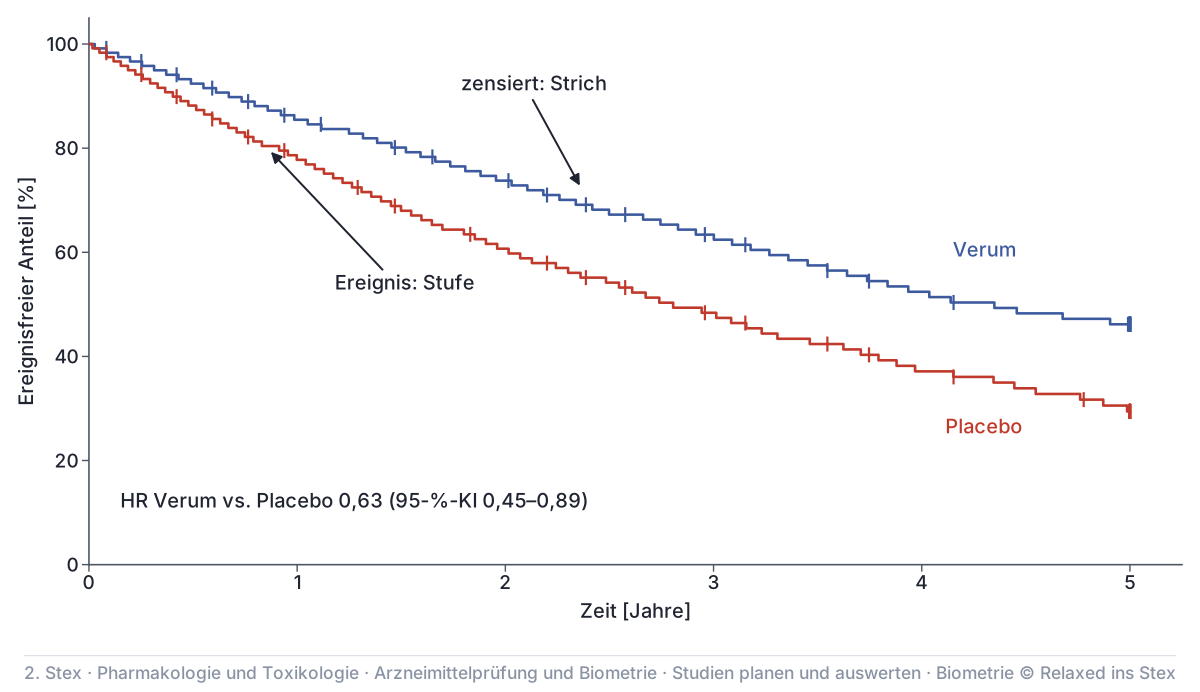
- Hazard Ratio (HR): Verhältnis der momentanen Ereignisraten über die Beobachtungszeit; HR 0,7 bedeutet eine um 30 % niedrigere Ereignisrate.
Die Kaplan-Meier-Kurve zeigt den Anteil ereignisfreier Patienten über die Zeit als Treppenfunktion. Wer vorzeitig ausscheidet, geht zensiert ein, statt verloren zu gehen.
Relative Angaben sind vom Basisrisiko unabhängig und klingen groß, den Nutzen zeigen erst ARR und NNT. Dieselbe RRR von 50 % bedeutet bei 0,4 % Basisrisiko nur 0,2 Prozentpunkte ARR, also NNT 500.
Wie Effektmaße mehrerer Studien zusammengeführt werden, steht unter Evidenzbasierte Medizin und Nutzenbewertung.
Diagnostische Tests
Die Güte eines diagnostischen Tests ergibt sich aus der Vierfeldertafel von Testergebnis und tatsächlichem Krankheitsstatus.
| Test | krank | gesund |
|---|---|---|
| positiv | richtig positiv (RP) | falsch positiv (FP) |
| negativ | falsch negativ (FN) | richtig negativ (RN) |
- Sensitivität: RP/(RP + FN), Anteil erkannter Kranker; hoch → geeignet zum Ausschluss.
- Spezifität: RN/(RN + FP), Anteil Gesunder mit negativem Test; hoch → geeignet zur Bestätigung.
- Positiver prädiktiver Wert (PPV): RP/(RP + FP), Wahrscheinlichkeit, bei positivem Test krank zu sein.
- Negativer prädiktiver Wert (NPV): RN/(RN + FN), Wahrscheinlichkeit, bei negativem Test gesund zu sein.
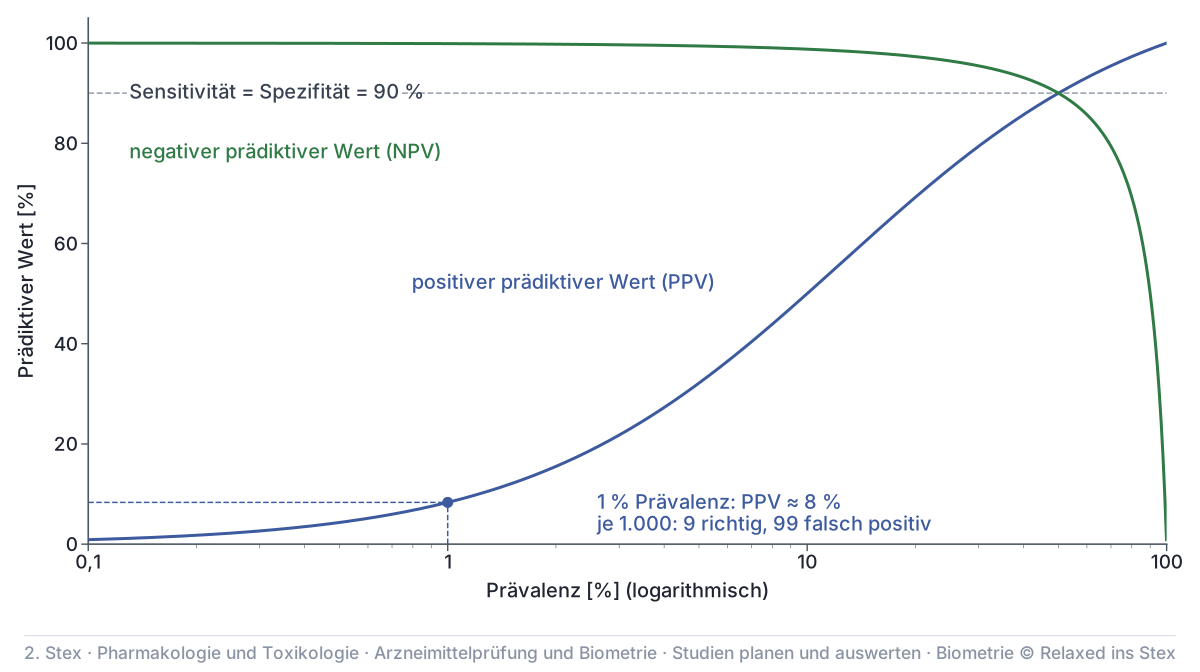
Sensitivität und Spezifität sind Eigenschaften des Tests, die prädiktiven Werte hängen von der Prävalenz ab. Bei je 90 % Sensitivität und Spezifität und 1 % Prävalenz sind von 1.000 Getesteten 9 richtig und 99 falsch positiv: der PPV liegt bei rund 8 %. Ein positiver Screeningbefund bei niedriger Prävalenz muss deshalb bestätigt werden.
Teste dich
Aussage 1
Ein Fehler 2. Art liegt vor, wenn eine in Wahrheit zutreffende Nullhypothese verworfen wird.
Das ist der Fehler 1. Art (α, falsch positiv). Der Fehler 2. Art (β) besteht darin, eine falsche Nullhypothese beizubehalten, also einen echten Effekt zu übersehen.
Zuordnen
Aussage 3
Der Median ist gegenüber Ausreißern robuster als der Mittelwert.
Der Median hängt nur von der Rangfolge ab, der Mittelwert von jedem einzelnen Wert. Deshalb nutzt man bei schiefen Verteilungen den Median.
Lückentext
Warum?
Aussage 6
Eine absolute Risikoreduktion von 2 Prozentpunkten entspricht einer Number needed to treat von 20.
NNT = 1/ARR = 1/0,02 = 50. Eine NNT von 20 entspräche einer ARR von 5 Prozentpunkten.
Aussage 7
Um einen kleineren Effekt nachzuweisen, braucht eine Studie bei gleicher Power und gleichem α weniger Patienten.
Umgekehrt: Je kleiner der erwartete Effekt, desto größer muss die Fallzahl sein, damit er sich vom Zufall abhebt.
Aussage 8
Sinkt die Prävalenz einer Erkrankung, sinkt der positive prädiktive Wert eines Tests, während Sensitivität und Spezifität gleich bleiben.
Sensitivität und Spezifität sind Testeigenschaften. Bei niedriger Prävalenz überwiegen die falsch Positiven, deshalb fällt der PPV.
Aussage 9
Der Standardfehler des Mittelwerts sinkt mit wachsender Fallzahl, die Standardabweichung bleibt dagegen etwa gleich.
SE = SD/√n wird mit größerem n kleiner, weil der Mittelwert präziser geschätzt wird; die SD beschreibt die Streuung der Einzelwerte und hängt nicht systematisch von n ab.
Prüferin fragt
Fehler entdeckt oder eine Idee? Wir verbessern die Inhalte laufend. Melde es uns gerne über dieses Formular ❤️
Teile der Inhalte wurden mithilfe von KI-Systemen erstellt und werden fortlaufend redaktionell geprüft. Trotz Sorgfalt können Fehler enthalten sein. Wichtige Informationen bitte anhand offizieller Quellen prüfen. Relaxed ins Stex ist ein unabhängiges Angebot und steht in keiner Kooperation mit dem IMPP. Das Angebot ist weder vom IMPP autorisiert noch mit diesem verbunden.